Cómo construir servicios digitales para redes poco fiables

Yamila FigueroaWebxya
Diseñar para redes poco fiables es más que acelerar la carga. Los servicios resilientes mantienen las tareas esenciales con conexiones lentas o inestables.
Introducción
Una persona completa un formulario, revisa la información y pulsa Enviar justo cuando desaparece la conexión. Desde el punto de vista del sistema, puede tratarse de un error de red. Desde el punto de vista de la persona, el problema es mucho más difícil de interpretar: ¿se recibió la solicitud?, ¿se guardó la información?, ¿es seguro volver a intentarlo?, ¿hacerlo creará un duplicado? Si la página se recarga, aparece además una preocupación más inmediata: si veinte minutos de trabajo están a punto de desaparecer.
Es en ese momento cuando una conectividad poco fiable deja de ser solo un problema de infraestructura y pasa a formar parte de la experiencia del producto. Un servicio que funciona bien únicamente mientras la red se comporta de forma predecible está haciendo una suposición que puede ser invisible durante el desarrollo, pero muy evidente durante el uso real.
En Por qué “Mobile First” no es suficiente en contextos humanitarios, analizamos las condiciones más amplias que determinan el acceso digital más allá del tamaño de pantalla. La conectividad merece una atención más profunda porque afecta prácticamente a todas las capas de un servicio digital: qué puede descargarse, qué información puede considerarse actual, cuándo puede guardarse el trabajo, cómo se confirman las acciones y qué debería comunicar la interfaz cuando el sistema no puede saber con certeza qué ocurrió.
Para los equipos que diseñan para bajo ancho de banda, el objetivo no tiene por qué ser conseguir que todas las funciones trabajen completamente offline. En muchos productos eso sería poco realista, innecesario o incluso inseguro. Un objetivo más útil consiste en identificar qué partes de la experiencia deben seguir siendo fiables cuando las condiciones de red empeoran y diseñar el producto para que esas tareas puedan continuar, pausarse, recuperarse o fallar de forma comprensible, en lugar de simplemente colapsar.
La conectividad no es binaria
Los productos digitales suelen reducir el estado de la red a una pareja sencilla: online u offline. La distinción es útil, pero solo describe los extremos de lo que las personas experimentan en la práctica.
Un dispositivo puede estar técnicamente conectado mientras una petición tarda treinta segundos en completarse. Puede disponer de suficiente conectividad para recuperar el HTML inicial, pero no para descargar un archivo multimedia pesado o completar una petición posterior a una API. Puede cambiar de red durante una transacción, experimentar pérdida temporal de paquetes o permanecer conectado a una red congestionada que, en la práctica, resulta casi inutilizable. En otros casos, la conexión puede funcionar correctamente pero ser lo bastante costosa como para que las personas limiten el uso de servicios que consumen muchos datos.
Estas situaciones importan porque no producen el mismo tipo de fallo. Una conexión lenta puede terminar completando una acción, mientras que una intermitente puede detenerla a mitad. Una red congestionada puede hacer que la interfaz parezca congelada aunque el dispositivo siga indicando que está conectado. Una conexión cara cambia la importancia de cada imagen, script o petición en segundo plano que no sea realmente necesaria.
La consecuencia práctica es que la conectividad se comporta más como un espectro de fiabilidad que como un estado booleano. Los navegadores y sistemas operativos pueden indicar que un dispositivo parece tener acceso a la red, pero eso no significa que la siguiente petición vaya a completarse, que el servidor vaya a responder o que la conexión vaya a mantenerse el tiempo suficiente para terminar una tarea. Diseñar para internet poco fiable implica, por tanto, contemplar las transiciones entre distintos estados, no solo el momento en que el dispositivo queda completamente offline.
Empieza por el recorrido crítico del usuario
Antes de decidir qué almacenar en caché, qué sincronizar o qué hacer disponible offline, los equipos necesitan entender qué está intentando conseguir la persona y qué partes de ese recorrido sería costoso perder.
En un servicio informativo, la resiliencia puede significar mantener legibles unas instrucciones consultadas previamente cuando desaparece la conexión. En un flujo de registro, puede significar conservar las respuestas localmente para que la persona pueda volver más tarde sin empezar de nuevo. En una herramienta de reporte de campo, puede significar registrar observaciones offline y sincronizarlas cuando regrese la conectividad. Una transacción financiera o sensible a la identidad, en cambio, puede necesitar una confirmación activa del servidor antes de que el servicio pueda afirmar con certeza que la acción se completó.
Estas diferencias son importantes porque evitan que la resiliencia se convierta en un ejercicio puramente técnico. La arquitectura adecuada depende de lo que requiera la tarea: qué información puede reutilizarse con seguridad, qué datos deben estar actualizados, qué acciones pueden esperar, cuáles necesitan confirmación inmediata y si resulta apropiado almacenar información localmente en el dispositivo en cuestión.
El servicio no necesita preservar todas las funciones en todas las condiciones. Necesita preservar las partes del recorrido que más importan y hacer comprensibles los límites de esa preservación.
La resiliencia comienza al decidir qué partes de una tarea deben seguir disponibles cuando la conectividad se vuelve poco fiable, aunque el contenido secundario no pueda mantenerse.
Reduce lo que necesita viajar por la red
Una vez definido el recorrido crítico, la siguiente pregunta es cuánta actividad de red necesita realmente esa experiencia.
Una página que depende de varias peticiones a APIs, múltiples archivos de fuentes, imágenes de alta resolución, scripts de terceros y un bundle considerable del lado cliente puede comportarse perfectamente en una conexión estable, pero cada dependencia añade otro punto en el que una red limitada o intermitente puede ralentizar la experiencia o interrumpirla por completo. En ese contexto, el trabajo de rendimiento deja de estar separado de la resiliencia; ambos empiezan a solaparse.
Las técnicas conocidas siguen siendo importantes: compresión, imágenes responsive, formatos modernos de imagen, code splitting, lazy loading del contenido secundario, evitar peticiones duplicadas, limitar scripts de terceros y devolver solo los datos que una vista necesita realmente. Sin embargo, su valor va más allá de mejorar una puntuación de velocidad. Reducir transferencias innecesarias disminuye el número de condiciones que deben cumplirse antes de que la experiencia esencial esté disponible.
El mismo principio se aplica a la arquitectura de la aplicación. Si una página puede renderizar contenido importante en el servidor, obligar a ese contenido a esperar por un bundle grande del lado cliente puede añadir fragilidad sin aportar un valor equivalente. Si varias peticiones a APIs pueden consolidarse de forma adecuada, la persona tendrá menos puntos de fallo. Si una imagen es decorativa, no debería determinar si unas instrucciones pueden leerse o un formulario puede completarse.
Un sitio diseñado para bajo ancho de banda no tiene por qué parecer visualmente pobre. El objetivo es impedir que los recursos secundarios controlen el acceso a la información principal.
Utiliza mejora progresiva
La mejora progresiva ofrece una forma útil de decidir qué capacidades pertenecen a la base de la experiencia y cuáles pueden añadirse cuando el entorno las soporta.
En un contexto web, esto puede significar empezar con HTML semántico, enlaces significativos, controles nativos, contenido renderizado en servidor cuando sea apropiado y comportamiento convencional del navegador antes de introducir una interacción más rica del lado cliente. JavaScript puede seguir desempeñando un papel importante, y algunos flujos de aplicación dependen realmente de él. La cuestión no es evitar frameworks modernos, sino evitar que una conveniencia de implementación se convierta en un requisito innecesario para poder acceder al servicio.
Esto se vuelve especialmente relevante con conectividad deficiente. Un enlace real puede seguir funcionando aunque el código de enhancement tarde en llegar. Un formulario resiliente dispone de más opciones si falla la hydration. El contenido esencial renderizado en el servidor puede seguir disponible incluso si los scripts secundarios nunca terminan de cargarse.
La pregunta arquitectónica importante no es si cada función puede sobrevivir sin JavaScript, sino si las partes más importantes del recorrido dependen de capas especialmente vulnerables a las restricciones de red y dispositivo. La mejora progresiva ayuda a hacer visible esa dependencia antes de que se convierta en un modo de fallo.
Usa la caché de forma intencional
La caché puede hacer que un servicio sea mucho más resiliente, pero solo cuando el equipo tiene claro qué se almacena, durante cuánto tiempo y bajo qué condiciones sigue siendo útil.
Los recursos estáticos, como hojas de estilo, iconos, scripts de interfaz y fuentes, suelen ser buenos candidatos para una caché de mayor duración porque sus versiones pueden controlarse. También puede ser útil conservar contenido de referencia relativamente estable para que la información consultada previamente siga disponible durante una interrupción.
Los datos dinámicos son más complejos. Una lista de oficinas almacenada en caché puede seguir siendo útil durante cierto tiempo, mientras que un estado de solicitud, una decisión de elegibilidad, una cita disponible, un inventario o un registro sensible a la seguridad pueden volverse engañosos o inseguros si la persona asume que están actualizados.
Por eso, las decisiones de caché deben considerar mucho más que el rendimiento. El equipo puede necesitar preguntarse cuánto puede envejecer una información antes de generar riesgo, si la interfaz debería mostrar cuándo se actualizó por última vez, si esos datos son apropiados para almacenarse en un dispositivo compartido y qué debería ocurrir cuando no es posible recuperar una versión más reciente.
La respuesta puede variar considerablemente dentro del mismo producto. La documentación puede seguir siendo útil durante días, mientras que una pantalla de estado puede necesitar una marca clara de “última actualización” después de apenas unos minutos. Los datos sensibles pueden no ser adecuados para almacenamiento persistente en absoluto. Utilizar la caché de forma intencional implica tratar estas diferencias como parte del diseño del producto y no aplicar una única política a todo.
Diseña estados offline que realmente sean útiles
Un mensaje a pantalla completa que diga Sin conexión a internet puede ser técnicamente correcto, pero a menudo dice muy poco sobre lo que la persona todavía puede hacer.
Cuando desaparece la conectividad, la interfaz debería distinguir entre las partes del servicio que ya no están disponibles y aquellas que pueden continuar. La información cargada previamente puede seguir siendo legible. Un borrador puede continuar editándose. La navegación por contenido almacenado en caché puede seguir funcionando, mientras que únicamente el envío final requiere una conexión activa.
Esto resulta mucho más útil que tratar el estado offline como un cierre total. Un estado offline bien diseñado puede mostrar cuándo se actualizó por última vez la información, dejar claro que un borrador está guardado en el dispositivo e indicar qué acciones necesitarán conectividad antes de poder completarse.
La interfaz también debe evitar prometer capacidades que no tiene. Un mensaje como “Lo enviaremos cuando vuelvas a tener conexión” solo es apropiado si el sistema dispone realmente de una cola y un mecanismo de sincronización fiables. Cuando no puede garantizar ese comportamiento, una explicación más precisa es más segura y más útil.
El diseño offline debería, por tanto, comunicar los límites del estado actual sin ocultar las partes de la tarea que todavía siguen siendo posibles.
Almacena y sincroniza con cuidado
Permitir que las personas sigan trabajando localmente parece sencillo hasta que ese trabajo local tiene que encontrarse con el estado remoto.
Guardar un borrador en el dispositivo es relativamente directo. Sincronizarlo más tarde introduce preguntas más difíciles. El mismo registro puede haber cambiado en el servidor. Una acción en cola puede enviarse dos veces. Varias operaciones pendientes pueden depender unas de otras. La sincronización puede completarse solo parcialmente. En un dispositivo compartido, además, la información almacenada localmente puede crear riesgos de privacidad que no existirían en un modelo de dispositivo privado.
La estrategia adecuada depende del tipo de acción. Los eventos append-only pueden ser comparativamente sencillos porque el servicio añade información nueva en lugar de reconciliar versiones que compiten entre sí. Los registros editables introducen conflictos porque dos versiones pueden ser válidas desde sus respectivos contextos. Las transacciones críticas requieren todavía más cuidado, ya que una acción registrada localmente no equivale necesariamente a una acción aceptada por el servidor.
Por ese motivo, los productos resilientes suelen necesitar distinguir varios estados en lugar de reducirlo todo a “guardado” o “completado”:
| Estado | Qué significa para la persona |
|---|---|
| Guardado localmente | El trabajo se conserva en este dispositivo, pero todavía no ha llegado al servidor. |
| Esperando conexión | La acción está en cola y aún no puede sincronizarse. |
| Sincronizando | El servicio está intentando enviar o reconciliar el cambio. |
| Confirmado | El servidor ha aceptado la acción y el servicio puede tratarla como completada. |
| Requiere atención | La sincronización falló, generó un conflicto o necesita una decisión antes de continuar. |
Estas diferencias pueden parecer simple contabilidad técnica, pero protegen a la persona frente a una falsa sensación de certeza. Un servicio no debería dar a entender que algo está completado cuando lo único que sabe es que la información se guardó localmente.
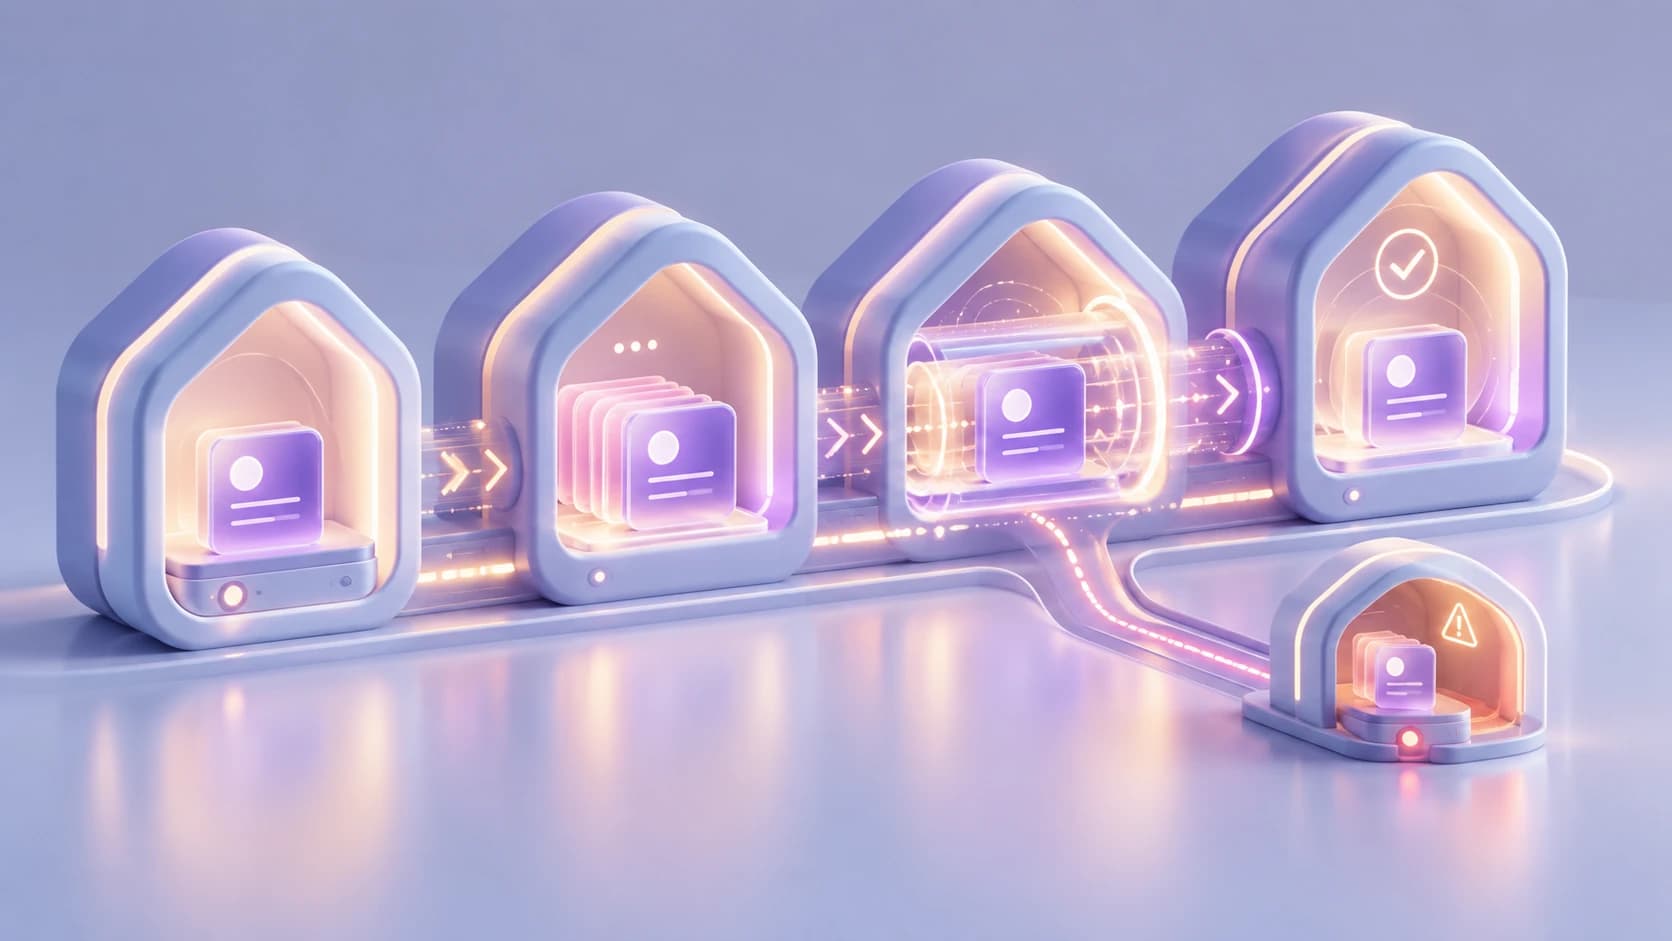
Los mismos datos pueden atravesar varios estados antes de quedar realmente confirmados. Una sincronización resiliente hace visibles esas transiciones y también cualquier ruta fallida.
Comunica claramente el estado de la red
Los productos suelen representar la conectividad con un icono global: verde para online, rojo para offline. Puede ser útil como información ambiental, pero rara vez responde a la pregunta que más importa a la persona: si su trabajo realmente se guardó, se envió o quedó confirmado.
La información de estado suele ser más útil cuando aparece cerca de la acción a la que afecta. Un borrador puede indicar que está guardado en el dispositivo. Una solicitud en cola puede mostrar que está esperando sincronización. La información recuperada previamente puede incluir una marca de “última actualización”, mientras que una acción que no pudo confirmarse debería decirlo de forma explícita y ofrecer un siguiente paso seguro cuando exista.
El lenguaje importa porque varios estados que suenan similares no son intercambiables. Algo puede estar guardado localmente sin estar sincronizado, sincronizado sin haberse enviado correctamente o enviado sin haber sido confirmado. Si la interfaz colapsa esas diferencias en un mensaje genérico de éxito, puede crear falsa certeza precisamente en el momento en que el sistema tiene menos certeza.
Una interfaz resiliente necesita comunicar el estado del trabajo de la persona, no solo el estado de la red.
Evita obligar a repetir el trabajo
Una de las consecuencias más visibles de una mala resiliencia de red es el esfuerzo repetido.
Cuando falla una conexión, una persona no debería tener que volver a introducir información simplemente porque el sistema no la conservó. Una solicitud larga no debería regresar al primer paso porque la petición final agotó el tiempo de espera. Una carga no debería reiniciarse automáticamente desde cero porque la red desapareció cerca del final. Un borrador no debería perderse porque la página se recargó inesperadamente.
Cada producto resolverá esto de una manera distinta. Autosave, borradores locales, cargas reanudables, persistencia entre pasos, peticiones idempotentes, reintentos seguros y colas cuidadosamente diseñadas pueden ayudar. El principio común es que la recuperación debe considerarse como parte de la propia tarea, no añadirse más tarde como una excepción.
Repetir trabajo tiene costes que van más allá de la frustración. Puede consumir datos, batería y tiempo adicionales. También puede introducir errores cuando las personas reconstruyen información de memoria y aumentar el abandono cuando la tarea ya era difícil o el acceso al dispositivo es limitado. Cuanto mayor sea el esfuerzo invertido, más deliberadamente debería el servicio proteger ese progreso.
Prueba en condiciones adversas
Un servicio desarrollado sobre banda ancha, equipos modernos, localhost y APIs que responden de forma consistente puede parecer muy resiliente sin haber sido sometido nunca a una presión significativa.
Las pruebas deben incluir las condiciones que la arquitectura afirma soportar. El network throttling es un buen punto de partida porque permite hacer visibles la latencia y el ancho de banda limitado durante el desarrollo, pero los equipos también deberían probar peticiones que agotan el tiempo de espera, conexiones que desaparecen a mitad de una acción, reconexiones después de varios minutos, páginas que cargan solo algunos recursos y sincronizaciones que se reanudan después de una interrupción prolongada.
Las limitaciones del dispositivo también importan. Un teléfono con poca memoria puede revelar problemas que no aparecen al aplicar throttling de red en un equipo potente. Del mismo modo, un servicio que se comporta de forma aceptable con una conexión lenta simulada puede reaccionar de manera distinta cuando entran en juego la pérdida de paquetes, la actividad en segundo plano, las limitaciones del navegador o hardware antiguo.
El objetivo no es simplemente medir si la página termina cargando. Los equipos también necesitan observar si el recorrido del usuario sigue siendo comprensible mientras el sistema se degrada. ¿Puede la persona saber que una acción está pendiente? ¿Sigue estando allí la información que ya introdujo? ¿La interfaz se recupera cuando vuelve la conectividad? ¿Puede distinguirse información antigua de información actual? Si se vuelve a intentar la misma petición, ¿el sistema evita duplicados?
Probar la resiliencia significa pensar en todo el recorrido: dónde puede ralentizarse, interrumpirse, recuperarse y seguir permitiendo que la persona continúe.
La resiliencia forma parte de la UX
El trabajo descrito en este artículo suele repartirse entre distintas disciplinas. El rendimiento puede quedar en manos de ingeniería, la caché en infraestructura, la sincronización en arquitectura de aplicación, los mensajes de error en UX writing y los estados offline en algún punto entre producto y frontend.
Las personas no experimentan esas fronteras. Experimentan si la página carga, si su trabajo se conserva, si la interfaz dice la verdad sobre lo que ocurrió y si pueden continuar cuando vuelve la red.
Por eso resilience-first resulta útil como principio de diseño. Ofrece a producto, diseño e ingeniería una forma compartida de evaluar la misma experiencia: qué ocurre con la tarea esencial cuando el entorno se vuelve menos fiable que aquel en el que se diseñó y probó el producto.
La respuesta no siempre será ofrecer funcionalidad offline completa. En un servicio puede significar una página más ligera; en otro, un borrador preservado, una marca temporal sobre información almacenada en caché, un estado pendiente más claro o un mecanismo de reintento que no pueda crear duplicados. Lo importante es que esas decisiones se tomen de forma deliberada y no se dejen a lo que ocurra cuando la red falle.
La resiliencia no exige que un producto elimine todos los posibles estados de fallo. Las redes seguirán desapareciendo, las peticiones seguirán agotando el tiempo de espera y algunas acciones seguirán necesitando una conexión activa antes de poder completarse con seguridad. La calidad de la experiencia depende de que esos momentos sigan siendo comprensibles y recuperables, sin convertir un problema temporal de infraestructura en trabajo perdido o en una tarea abandonada.
- Resiliencia digital
- Baja conectividad
- Offline First
- Rendimiento
- Mejora progresiva
Sigue leyendo
Accesibilidad
Accesibilidad digital para ONG: ¿por dónde empezar?
Las ONG no necesitan resolver todos los problemas de accesibilidad de una vez. Empieza por lo crítico, fija una línea base y deja de crear barreras nuevas.
La deuda de accesibilidad se acumula cuando una decisión inaccesible se repite en componentes, contenido, código y procesos. Cuanto más se propaga, más cuesta.
Si estos retos te resultan familiares, hablemos de tu contexto.
Conversemos